
Ce qu’il faut retenir :
- 276 sites sur 7 047 nomment OAI-SearchBot dans leur robots.txt, le robot qui alimente les réponses de ChatGPT. 96 % n’ont jamais statué, ni pour l’autoriser ni pour le bloquer.
- 79,6 % des robots.txt français ne nomment aucun agent IA. Le sujet n’existe pas dans huit fichiers sur dix.
- 13,5 % bloquent GPTBot, le robot d’entraînement d’OpenAI, contre 3,3 % pour OAI-SearchBot. Ceux qui bloquent l’entraînement le font méthodiquement, sept robots nommés en médiane, et 6,9 % seulement nomment OAI-SearchBot.
- Les médias bloquent cinq fois plus que les sites institutionnels : 25,3 % contre 4,7 % sur GPTBot.
- 10,2 % publient un llms.txt. 97 % de ces fichiers ne reçoivent jamais une seule requête.
- 38,4 % des sites testés n’exposent aucun H1 dans leur HTML brut, ce qu’aucun robot IA sauf Google et Apple ne compense, faute d’exécuter le JavaScript.
- À partir du 15 septembre 2026, Cloudflare bloque par défaut les robots d’entraînement et les agents sur les pages publicitaires des nouveaux domaines. Un tiers du corpus est derrière Cloudflare.
Robots IA : les sites français ont-ils choisi d’être visibles dans ChatGPT ?
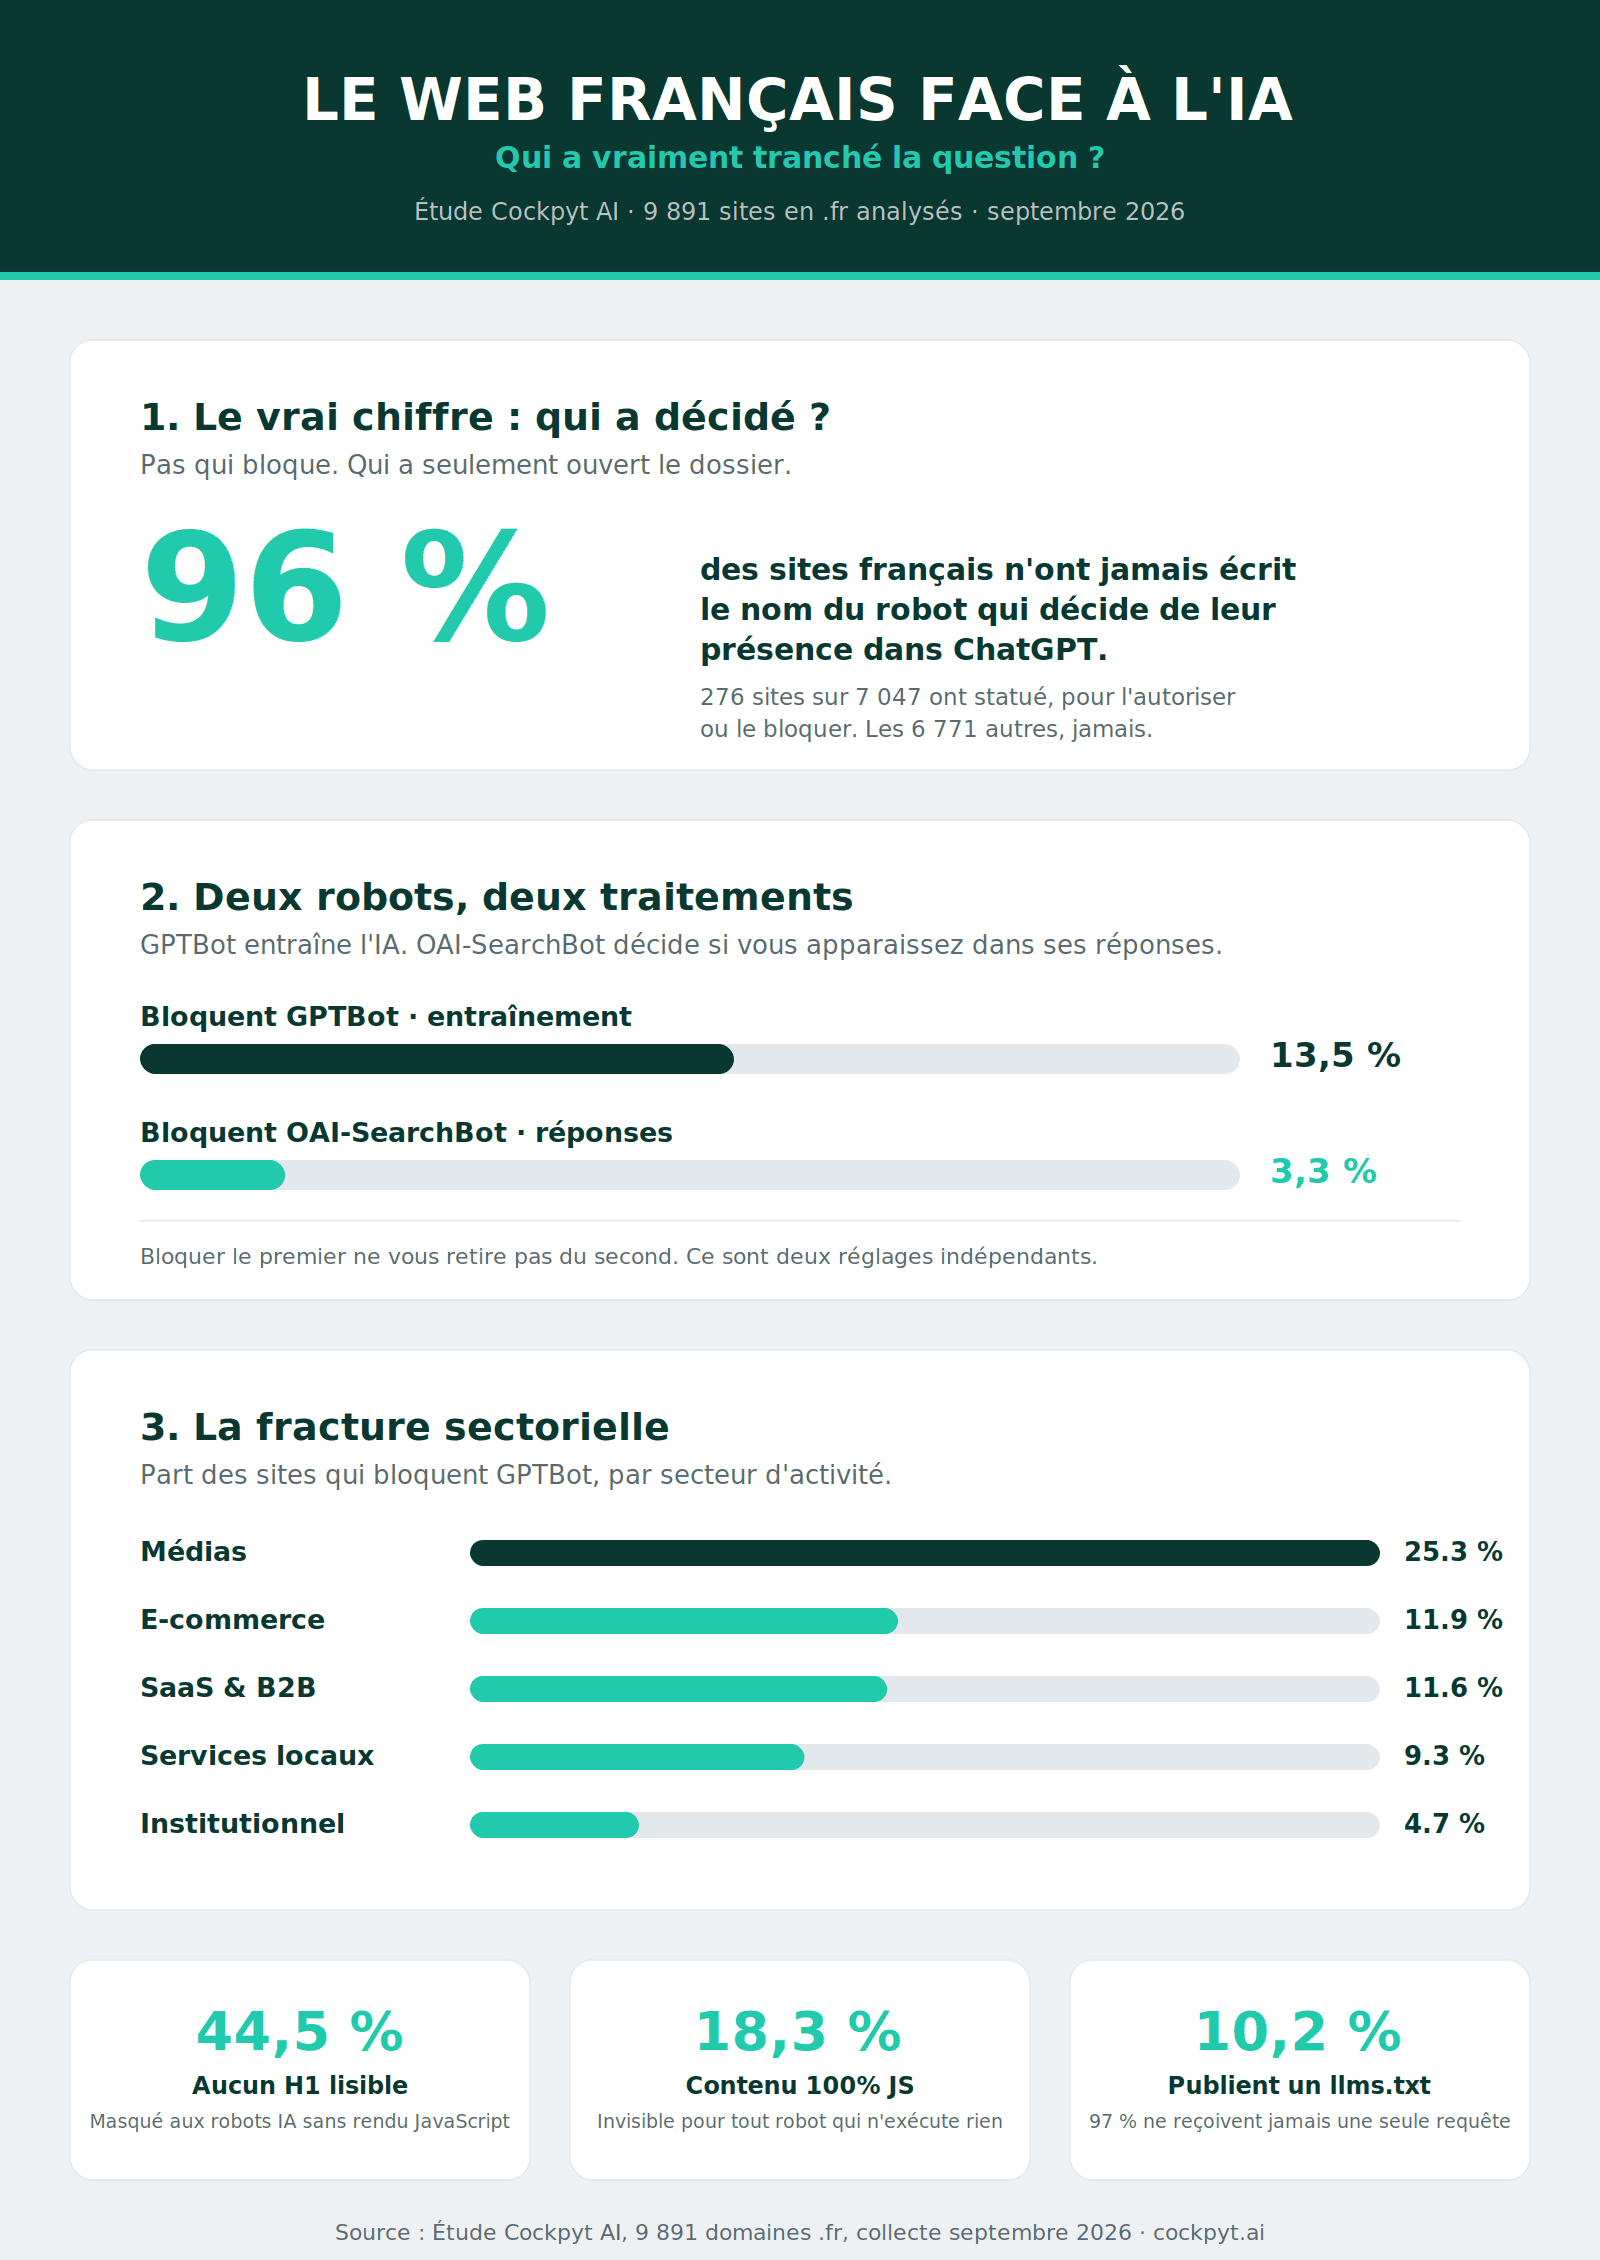
Avec Cockpyt AI, nous avons analysé le robots.txt de 9 891 domaines en .fr pour répondre à cette question. La réponse tient en un chiffre : 276 sites ont écrit le nom du robot qui décide de leur présence dans ChatGPT. Les 6 771 autres ne l’ont jamais fait.
Il n’existe pas « un robot ChatGPT ». OpenAI en fait tourner plusieurs, aux rôles distincts, et chacun se pilote séparément. Bloquer celui qui collecte des données d’entraînement ne vous retire pas des réponses affichées à l’écran.
Une partie du web a tranché. 13,5 % bloquent les robots d’entraînement, et ils le font avec méthode. Cette minorité occupe tout le débat public depuis trois ans.
La majorité, elle, n’a pas ouvert le dossier. Ce n’est pas un reproche, c’est un constat mesurable, et c’est le sujet de cette étude.
Cette étude mesure l’écart entre l’intention et le résultat. Elle porte sur des données collectées en septembre 2026, avec les intervalles de confiance et la méthodologie détaillée en fin d’article.
Le calendrier lui donne une valeur particulière. Le 15 septembre 2026, Cloudflare applique de nouveaux réglages par défaut aux robots IA. Ces chiffres sont donc une photographie du parc français prise juste avant le basculement.
Et votre marque, ChatGPT la recommande-t-il ?
Mesurez votre présence et identifiez les marques citées à votre place. Sans carte bancaire.
96 % des sites français n’ont jamais statué sur leur visibilité dans ChatGPT
276 sites sur 7 047 nomment OAI-SearchBot dans leur robots.txt. Ce chiffre ne dit pas combien le bloquent, il dit combien y ont pensé.
Un fichier robots.txt ne contient que ce que son auteur a décidé d’y mettre. Nommer un agent, quel que soit le verdict qui suit, prouve qu’on a ouvert la question. Ne pas le nommer prouve l’inverse.
| Sur les 7 047 sites disposant d’un robots.txt | Nombre | Part |
|---|---|---|
| Ne nomment aucun agent IA, ni entraînement ni réponse | 5 608 | 79,6 % |
| N’ont jamais statué sur un robot de réponse IA | 6 509 | 92,4 % |
| N’ont jamais nommé OAI-SearchBot | 6 771 | 96,1 % |
| Ont nommé OAI-SearchBot, pour l’autoriser ou le bloquer | 276 | 3,9 % |
Ajoutez-y les 21,1 % de sites français qui n’ont aucun robots.txt, et le tableau se complète : l’écrasante majorité du web français n’a pris aucune position sur son accès aux moteurs de réponse.
Ce silence n’est pas neutre. Sans directive, l’accès est autorisé par défaut, ce qui est probablement le bon résultat pour la plupart des sites. Mais un résultat par défaut n’est pas une décision : il change le jour où un prestataire ajoute une règle, où un CMS régénère le fichier, ou où un hébergeur modifie ses réglages. Personne ne s’en apercevra, puisque personne ne surveille.
D’après moi, c’est le vrai enseignement de cette étude. La question qui agite le secteur depuis trois ans, faut-il bloquer les IA, concerne 13,5 % du parc. Les 86,5 % restants n’en sont pas là. Ils ne savent pas ce que leur configuration actuelle autorise, et ils n’ont aucun moyen de le savoir tant qu’ils ne l’ont pas regardée.
Ce que révèle l’analyse de 9 891 sites français
78,9 % des sites disposent d’un robots.txt valide, soit 7 047 sites sur les 8 927 joignables. C’est sur cette base que se calculent tous les taux de blocage ci-dessous.
Le classement des robots bloqués dessine une hiérarchie nette. Les robots d’entraînement prennent les premières places, les robots de réponse ferment la marche.
| Robot | Rôle réel | Sites qui le bloquent | Intervalle à 95 % |
|---|---|---|---|
| CCBot | Entraînement (Common Crawl) | 13,9 % | 13,2 – 14,8 |
| GPTBot | Entraînement OpenAI | 13,5 % | 12,7 – 14,3 |
| Amazonbot | Usage mixte Amazon | 12,9 % | 12,1 – 13,7 |
| Bytespider | Entraînement ByteDance | 12,7 % | 11,9 – 13,5 |
| ClaudeBot | Entraînement Anthropic | 12,1 % | 11,3 – 12,9 |
| meta-externalagent | Entraînement Meta | 11,2 % | 10,5 – 12,0 |
| Google-Extended | Entraînement et ancrage Gemini | 11,1 % | 10,4 – 11,9 |
| Applebot-Extended | Entraînement Apple | 10,2 % | 9,5 – 10,9 |
| ChatGPT-User | Récupération déclenchée par un utilisateur | 5,1 % | 4,6 – 5,6 |
anthropic-ai |
Nom d’agent obsolète | 5,0 % | 4,5 – 5,5 |
| PerplexityBot | Recherche Perplexity | 4,0 % | 3,6 – 4,5 |
| OAI-SearchBot | Réponses de ChatGPT | 3,3 % | 2,9 – 3,7 |
| Claude-SearchBot | Réponses de Claude | 2,7 % | 2,4 – 3,1 |
| Applebot | Recherche Apple | 2,1 % | 1,8 – 2,5 |
| Bingbot | Recherche Bing, socle de Copilot | 1,2 % | 1,0 – 1,5 |
| Googlebot | Recherche Google et AI Overviews | 0,9 % | 0,7 – 1,2 |
L’écart est de un à quatre entre GPTBot et OAI-SearchBot. Ces deux robots appartiennent au même éditeur, se pilotent avec deux lignes voisines dans le même fichier, et se retrouvent traités de façon radicalement différente.
Le robots.txt n’est pas le seul verrou. 10,2 % des sites publient un llms.txt, et deux sites sur l’ensemble du corpus utilisent l’en-tête X-Robots-Tag: noai. Ce dernier chiffre dit tout de l’adoption réelle de ce signal.
Pourquoi bloquer GPTBot ne vous retire pas de ChatGPT
GPTBot et OAI-SearchBot font deux métiers différents. Le premier collecte du contenu susceptible d’entraîner les futurs modèles. Le second alimente la fonction de recherche de ChatGPT, celle qui va chercher des pages et affiche des liens sous la réponse.
La documentation d’OpenAI est explicite sur ce point : « Each setting is independent of the others ». Chaque réglage se pilote séparément. Un éditeur peut autoriser OAI-SearchBot pour apparaître dans les résultats tout en refusant GPTBot. L’inverse est tout aussi possible, et c’est exactement ce que font 727 sites de mon échantillon sans le savoir.
Le même piège existe chez Google, en pire. Google-Extended n’est pas un robot, c’est un jeton de contrôle : aucune requête ne part sous ce nom, Googlebot continue de crawler normalement et le jeton indique simplement si le contenu récupéré peut servir à entraîner Gemini ou à l’ancrer. Google a d’ailleurs revu cette documentation pour clarifier l’impact sur la recherche, précisément parce que le sujet inquiétait les éditeurs qui choisissent de bloquer ce jeton.
Conséquence directe : bloquer Google-Extended ne vous retire pas des AI Overviews, qui piochent dans l’index de recherche alimenté par Googlebot. 719 sites français, soit 10,2 %, se trouvent dans cette situation.
Ces sites ont choisi, et j’ai vérifié
10,3 % des sites français bloquent GPTBot en laissant OAI-SearchBot ouvert. Dire que c’est une erreur serait un procès d’intention. J’ai donc mesuré plutôt que supposé.
Un fichier robots.txt nomme des agents. La liste de ceux qu’il nomme dit ce que son auteur connaissait au moment de l’écrire. Voici ce que contiennent les fichiers de ces 727 sites.
| Ce que nomme explicitement leur robots.txt | Part des 727 sites |
|---|---|
| Au moins un robot d’entraînement autre que GPTBot | 95,2 % |
| Google-Extended | 78,4 % |
| Applebot-Extended | 73,0 % |
| Au moins un robot de recherche | 22,8 % |
L’agent obsolète anthropic-ai |
16,8 % |
| OAI-SearchBot | 6,9 % |
Ces fichiers ne sont pas de vieux copiés-collés. Ils nomment en médiane sept robots d’entraînement différents, dont Applebot-Extended et meta-externalagent, deux identifiants apparus après 2024. Personne n’écrit ces noms par hasard. La politique anti-entraînement est délibérée, tenue à jour, et appliquée méthodiquement à toute la famille.
Le même fichier ne dit rien de la famille recherche. 22,8 % nomment au moins un robot de recherche, 6,9 % nomment OAI-SearchBot. Autrement dit, 93 % de ces sites n’ont jamais statué sur le robot qui décide de leur présence dans les réponses de ChatGPT.
Ce n’est ni un accident ni un choix complet. C’est une politique construite sur un modèle mental binaire, l’entraînement contre le reste, dans lequel les robots de réponse n’ont pas de case. Ils ne sont pas autorisés par décision, ils sont autorisés par défaut d’existence.
D’après moi, c’est une bonne nouvelle mal exploitée. Ces 727 sites se trouvent dans la configuration que je recommande : refuser l’entraînement, accepter la citation. Elle tient tant que rien ne bouge. Le jour où un prestataire ajoute un Disallow générique, où un CMS régénère le fichier ou où l’hébergeur change ses réglages par défaut, elle se défait sans que personne l’ait décidé. Une position qu’on n’a pas écrite est une position qu’on ne peut pas défendre.
Un dernier chiffre confirme que le sens de la protection est compris : la configuration inverse, accepter l’entraînement en refusant la citation, concerne 9 sites sur 7 047.
D’après moi, cette confusion ne vient pas d’une négligence mais d’un décalage de vocabulaire. Les éditeurs raisonnent en marques, ChatGPT, Gemini, Claude. Les fichiers robots.txt raisonnent en fonctions, entraînement, recherche, récupération à la demande. Tant que les deux logiques ne se rejoignent pas, le blocage restera approximatif.
Ceux qui ont décidé se méfient de l’entraînement, jamais du trafic
Parmi la minorité qui a tranché, la ligne de partage est nette. 824 sites écrivent un groupe User-agent: GPTBot pour lui refuser l’accès. Pour Googlebot, ce nombre tombe à zéro.
Les 0,9 % de sites où Googlebot se trouve bloqué le sont tous par ricochet, via un User-agent: * restrictif que personne n’a écrit en pensant à lui. Le calcul distingue les deux cas :
- Décision explicite : un groupe nomme le robot. C’est un choix assumé, documenté dans le fichier.
- Effet de bord : le robot tombe sous une règle générique. Personne n’a tranché, le blocage arrive par accident.
Sur l’ensemble du corpus, environ 125 sites se retrouvent coupés d’OAI-SearchBot par simple effet de bord, soit 1,8 %. Ces sites-là n’ont pris aucune décision sur l’IA. Ils ont écrit une règle large il y a des années, souvent pour protéger une zone d’administration, et cette règle mord aujourd’hui sur des robots qui n’existaient pas à l’époque.
Le contraste GPTBot/Googlebot dit quelque chose de simple sur le rapport au risque. Personne ne coupe la branche qui apporte du trafic. Tout le monde se méfie de ce qui ressemble à du pillage. Le problème est que la frontière entre les deux ne passe pas là où les éditeurs la placent.
222 sites bloquent un robot qui n’existe plus
Un chiffre m’a arrêté pendant l’analyse. 222 sites nomment explicitement anthropic-ai dans leur robots.txt. Cet identifiant circulait dans les articles de blog de 2023, Anthropic ne l’utilise plus. Dans le même corpus, 62 sites seulement bloquent Claude-SearchBot, le robot qui alimente réellement les réponses de Claude.
Trois fois plus de sites bloquent un fantôme que le robot en service. C’est la démonstration la plus directe de ce que sont devenus ces fichiers : des copiés-collés d’articles vieux de trois ans que personne n’a relus depuis. Le même schéma se répète chez Apple, où Applebot-Extended est bloqué par 10,2 % des sites contre 2,1 % pour Applebot.
233 sites refusent un visiteur qui vient vers eux
ChatGPT-User est bloqué par 5,1 % des sites. Ce robot n’explore rien de sa propre initiative : il va chercher une page parce qu’un utilisateur a demandé à ChatGPT de la consulter. Le refuser revient à fermer la porte à quelqu’un qui frappe. OpenAI précise en plus que les règles robots.txt ne s’y appliquent pas nécessairement, ce qui rend le blocage à la fois hostile et incertain.
La configuration inverse, accepter l’entraînement tout en refusant la visibilité, n’existe pratiquement pas : 9 sites sur 7 047. Cette asymétrie est saine, elle montre que le sens de la protection est compris. Ce sont les moyens qui suivent mal.
Les médias sont le seul secteur à se couper vraiment
25,3 % des médias bloquent GPTBot, contre 4,7 % des sites institutionnels. Cinq fois plus. Et cet écart se retrouve sur le robot qui compte : 7,3 % des médias bloquent OAI-SearchBot, contre 1,3 % des sites institutionnels.
| Secteur | Sites analysés | Bloquent GPTBot | Bloquent OAI-SearchBot |
|---|---|---|---|
| Médias | 620 | 25,3 % [22,1 – 28,9] | 7,3 % [5,5 – 9,6] |
| E-commerce | 1 512 | 11,9 % [10,4 – 13,6] | 1,1 % [0,7 – 1,8] |
| SaaS et B2B | 363 | 11,6 % [8,7 – 15,3] | 1,4 % [0,6 – 3,2] |
| Services locaux | 237 | 9,3 % [6,2 – 13,7] | 4,6 % [2,6 – 8,1] |
| Institutionnel | 232 | 4,7 % [2,7 – 8,3] | 1,3 % [0,4 – 3,7] |
| Ensemble | 7 047 | 13,5 % [12,7 – 14,3] | 3,3 % [2,9 – 3,7] |
Les intervalles des médias et de l’institutionnel ne se recouvrent pas. L’écart tient statistiquement, il ne relève pas du bruit d’échantillonnage.
La lecture est cohérente avec la position des éditeurs de presse sur la valeur de leurs archives. Les médias sont les seuls à avoir mené une réflexion collective sur le sujet, et cela se voit dans leurs fichiers. Ils sont aussi les seuls à bloquer significativement les robots de réponse, donc à accepter de perdre de la visibilité dans ChatGPT en échange d’un contrôle sur leur contenu.
À l’autre bout, les sites institutionnels laissent presque tout ouvert. Mairies, écoles, administrations : leur mission est de diffuser, pas de monétiser l’accès. Le résultat est logique, il valait la peine d’être chiffré.
Ce que voit un robot IA qui ne peut pas prouver son identité
18,2 % des sites refusent au moins une requête se présentant comme un robot IA sans pouvoir le prouver. Ce chiffre ne mesure pas le blocage des vrais robots, et il faut le dire avant tout le reste.
J’ai mesuré cela en interrogeant la même page d’accueil avec sept identités différentes, dont un navigateur Chrome comme référence, Googlebot, et quatre robots IA. Seul l’écart par rapport à Chrome est interprétable.
Sur les 829 sites qui répondent normalement à un navigateur, 18,2 % refusent au moins un user-agent IA. Dans 14,7 % des cas le blocage vise les robots IA en laissant passer Googlebot, ce qui ressemble à une décision. Dans 3,5 % des cas il s’agit d’un dispositif anti-robot générique qui refuse tout ce qui n’est pas un navigateur, IA comprise.
J’envoie ces requêtes depuis une adresse IP ordinaire. Les pare-feu sérieux valident les robots par plages d’IP publiées et résolution DNS inverse. Un pare-feu qui refuse ma requête fait donc exactement son travail : il bloque une usurpation d’identité. Ce n’est pas une erreur de configuration, c’est de la bonne sécurité, et le vrai GPTBot, lui, passerait probablement.
Ce chiffre garde deux usages, et aucun des deux ne consiste à accuser les équipes d’infrastructure.
Le premier est pratique. Un site qui refuse un user-agent IA non vérifié refuse aussi la plupart des outils d’audit GEO du marché, qui ne disposent pas d’IP validées par les éditeurs de LLM. Si vos rapports de visibilité affichent des pages vides sans explication, la cause est souvent là, et elle n’a rien à voir avec votre robots.txt.
Le second concerne l’écart entre les deux couches. Chez 10,8 % des sites, le fichier autorise pendant que le réseau refuse une requête non vérifiée. Chez 6,3 %, c’est l’inverse : le fichier interdit, le réseau laisse passer. Ce second cas est le plus intéressant, parce qu’il montre un site qui croit avoir fermé une porte restée ouverte pour tout client qui ne lit pas le robots.txt.
Cloudflare apparaît sur 2 930 sites du corpus, largement en tête des infrastructures détectées. C’est le principal endroit où ces règles se configurent, souvent par une équipe différente de celle qui écrit le robots.txt. D’après moi, c’est la cause profonde de ces contradictions : deux équipes, deux décisions, aucune conversation entre les deux.
15 septembre 2026, Cloudflare déplace la décision hors de votre robots.txt
2 930 sites de mon corpus sont derrière Cloudflare, soit un tiers du total. C’est de loin la première infrastructure détectée, devant les serveurs Apache et Nginx exposés en direct.
Le 15 septembre 2026, Cloudflare remplace son interrupteur binaire par une classification en trois comportements : Search pour les robots qui indexent, Agent pour ceux qui agissent en temps réel pour un utilisateur, Training pour ceux qui alimentent l’entraînement des modèles. Sur les pages détectées comme affichant de la publicité, Training et Agent passent bloqués par défaut, Search reste autorisé.
Le périmètre couvre les nouveaux clients, les nouveaux sites des clients existants, et l’ensemble des comptes gratuits actuels. Les réglages se modifient depuis le tableau de bord, avant ou après la date.
Un piège mérite d’être connu : un robot qui porte plusieurs étiquettes suit la règle la plus stricte. Bloquer Training peut donc entraîner le blocage de robots multi-usages comme Googlebot, Bingbot ou Applebot. Le réglage qui protège votre contenu peut vous retirer de la recherche classique.
Le changement de fond est ailleurs. Pendant vingt-cinq ans, l’arbitrage sur l’accès des robots vivait dans un fichier texte à la racine du site, sous le contrôle de l’équipe SEO. Il remonte maintenant vers le compte CDN, géré par l’équipe infrastructure. C’est exactement la faille que mesure la section précédente, et elle va s’élargir.
D’après moi, la conséquence pratique est simple. Le robots.txt reste une déclaration d’intention, il n’a jamais été un verrou. À partir de demain, la réponse à la question « mon site est-il accessible aux IA » ne se lit plus dans un seul endroit. Il faut vérifier les deux couches, et vérifier qui a la main sur chacune.
38 % des sites n’ont pas de H1 dans leur HTML brut
Le blocage volontaire est visible. Le blocage involontaire l’est beaucoup moins, et il touche plus de monde.
Une objection revient souvent : les moteurs IA rendraient aujourd’hui le JavaScript, ce qui rendrait le sujet obsolète. Les mesures disent le contraire. L’analyse de Vercel et MERJ, portant sur plus de 500 millions de requêtes de robots, ne trouve aucune exécution de JavaScript chez GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot, Bytespider ni meta-externalagent. Ces robots téléchargent parfois les fichiers JavaScript, ils ne les exécutent jamais. Les seules exceptions sont Googlebot, dont Gemini réutilise l’infrastructure de rendu, et Applebot.
Sur 781 sites dont j’ai comparé le HTML brut et le HTML rendu par un navigateur, 38,4 % n’exposent aucun titre H1 avant exécution du JavaScript. 18,3 % ont leur contenu principal entièrement dépendant du JavaScript. 4,6 % voient leur balisage JSON-LD injecté par script, donc invisible pour tout robot qui ne rend pas les pages.
Le ratio médian entre texte brut et texte rendu s’établit à 0,89. La majorité des sites s’en sortent correctement. La queue de distribution concentre le problème, et ce sont souvent des sites récents, construits sur des frameworks modernes sans rendu serveur.
D’autres signaux racontent la même histoire d’un web mal préparé aux moteurs de réponse. 23 % seulement des pages d’accueil exposent une date de mise à jour, et à peine 0,5 % l’affichent en clair dans le texte. 13,8 % identifient un auteur. 2,4 % déclarent un nœud Person en JSON-LD. Un site sur deux n’a pas de H1 unique.
Ces chiffres portent sur la page d’accueil uniquement, qui n’est pas une page d’article. Ils donnent malgré tout une idée du niveau de préparation moyen : la plupart des sites français n’ont rien mis en place pour être compris par une machine qui compose une réponse.
10,2 % des sites français publient un llms.txt
911 sites du corpus exposent un fichier llms.txt à leur racine. Ce taux surprend, il est pourtant conforme aux mesures publiées ailleurs : SE Ranking trouve environ un site sur dix sur 300 000 domaines, Presenc.AI relève 10,13 %, et Ahrefs monte à 28 % sur 137 210 domaines recevant du trafic. Mon 10,2 % est au milieu de cette fourchette.
Ce format propose de décrire un site en Markdown à destination des modèles de langage. Le problème n’est pas son adoption, c’est son usage réel. L’étude Ahrefs de mai 2026 constate que 97 % de ces fichiers n’ont reçu aucune requête sur le mois observé, ni de robot ni d’humain. SE Ranking ne trouve aucune corrélation entre la présence d’un llms.txt et la fréquence de citation par les LLM.
La comparaison avec les autres chiffres de l’étude est plus intéressante que le taux lui-même. Trois fois plus de sites publient un llms.txt qu’il n’y en a qui bloquent OAI-SearchBot. Pour le dire autrement, les éditeurs français adoptent plus volontiers un format spéculatif qu’ils ne relisent le fichier qui décide réellement de leur accessibilité.
Lire aussi : llms.txt : 3 études disent non, Lighthouse oui
Une précision de méthode, parce que l’objection est légitime. Beaucoup de CMS renvoient un code 200 accompagné d’une page d’accueil quand on demande un fichier inexistant, ce qui gonfle mécaniquement ce type de comptage. Un premier passage remontait 1 025 fichiers. En exigeant du texte brut structuré en Markdown, en écartant tout ce qui contient du HTML et tout ce qui ressemble à une page d’erreur, 114 disparaissent. Les 911 restants sont des fichiers réels.
Le seul usage documenté de ce format se situe ailleurs que dans les moteurs de réponse : les assistants de développement et les serveurs de documentation le consomment activement, ce qui explique son adoption dans la tech et le SaaS.
À l’autre extrémité de l’adoption, l’en-tête X-Robots-Tag: noai est utilisé par 2 sites sur 8 927. Ce signal, poussé un temps comme une alternative au robots.txt, n’existe pas dans la pratique.
Ce que vous pouvez vérifier en cinq minutes
Commencez par la question la plus simple : votre fichier nomme-t-il un seul agent IA ? Si la réponse est non, vous n’avez rien à corriger, vous avez une décision à prendre. Ensuite, dans cet ordre.
- Votre groupe
User-agent: *: listez ce qu’il interdit. Toute règle qui s’applique aux robots IA sans que vous l’ayez voulu commence ici. - Les robots de réponse : OAI-SearchBot, Claude-SearchBot, PerplexityBot et Googlebot. Si l’un d’eux est bloqué, vous perdez de la visibilité, pas du contrôle.
- Les robots d’entraînement : GPTBot, ClaudeBot, Google-Extended, CCBot. Les bloquer est un choix défendable, à condition de savoir qu’il ne change rien à votre présence dans les réponses.
- Votre pare-feu : vérifiez que ses règles disent la même chose que votre fichier. Chez un site sur dix, elles se contredisent.
- Votre tableau de bord Cloudflare, si vous en avez un : depuis le 15 septembre 2026, les catégories Training et Agent y sont bloquées par défaut sur les pages publicitaires des nouveaux domaines.
Le piège le plus fréquent tient en une ligne. Un groupe User-agent: * avec Disallow: / sur un environnement de préproduction resté en ligne, ou une règle héritée d’un ancien chantier. Personne ne relit ce fichier, et il décide pourtant de votre présence dans les réponses IA.
Une fois l’accès vérifié, la question suivante devient mesurable : les IA vous citent-elles, et sur quelles requêtes. L’accès est une condition nécessaire, il n’a jamais suffi.
Méthodologie
Transparence. Cette étude est publiée par Cockpyt AI, qui édite un outil payant de suivi de visibilité dans les IA. Les données brutes agrégées sont téléchargeables, la méthode de collecte est décrite ci-dessous, et les recommandations de cet article se mettent en œuvre avec un éditeur de texte, sans aucun outil. Jugez les chiffres, pas l’enseigne.
L’étude porte sur 9 891 domaines en .fr, collectés en septembre 2026. 8 927 ont répondu, soit 90,3 %. Les 964 restants ont été écartés pour échec DNS, erreur TLS ou dépassement de délai. Tous les taux ont pour dénominateur les domaines joignables, et chaque pourcentage est accompagné de son intervalle de Wilson à 95 %.
L’analyse du robots.txt suit la RFC 9309 : un robot n’obéit qu’au groupe dont le jeton correspond au préfixe le plus long de son nom, les groupes portant ce même jeton sont fusionnés, et à défaut le groupe générique s’applique. Le calcul distingue systématiquement la décision explicite de l’effet de bord.
La couche réseau a été mesurée sur un sous-échantillon, avec sept user-agents par domaine, deux secondes entre chaque requête et abandon immédiat du domaine au premier code 429. Elle mesure la réaction à un user-agent IA non vérifié et n’est jamais fusionnée avec les chiffres du robots.txt.
La segmentation sectorielle repose sur le contenu des pages d’accueil : type déclaré en JSON-LD, marqueurs de panier, intitulé de la page. Seuls les classements sûrs entrent dans le calcul, ce qui ramène la base sectorielle à 2 964 sites. J’ai testé deux jeux de règles de classification : le classement des secteurs reste identique dans les deux cas, et l’écart entre médias et institutionnel se creuse plutôt qu’il ne se réduit.
Limites assumées. Le corpus est un corpus de domaines en .fr, ce qui ne garantit pas que chaque site soit édité depuis la France : 70,3 % déclarent explicitement lang="fr". Les signaux de structure portent sur la page d’accueil seule, qui n’est pas une page d’article. La mesure réseau n’utilise aucune IP validée par les éditeurs de LLM, elle ne dit donc rien du sort réservé aux robots authentifiés. Un robots.txt dit ce qu’un site déclare, jamais ce qu’un éditeur pense : l’analyse des agents nommés est le meilleur indice d’intention dont je dispose, ce n’est pas une preuve. Enfin, ces chiffres sont une photographie à une date donnée, et la politique par défaut des hébergeurs évolue vite.
Questions fréquentes
Comment savoir si mon site a déjà pris position sur les robots IA ?
Ouvrez votre robots.txt et cherchez les noms d’agents : GPTBot, OAI-SearchBot, ClaudeBot, Google-Extended. Si aucun n’apparaît, personne n’a jamais statué chez vous, et vous êtes dans le cas de 79,6 % des sites français. L’accès est alors autorisé par défaut, ce qui convient à la plupart des sites, mais ce n’est pas une position tenue.
Bloquer GPTBot retire-t-il mon site de ChatGPT ?
Non. GPTBot collecte des données d’entraînement. Les réponses que ChatGPT affiche en allant chercher des pages passent par OAI-SearchBot, et les récupérations déclenchées par un utilisateur passent par ChatGPT-User. Ce sont trois réglages indépendants.
Bloquer Google-Extended me retire-t-il des AI Overviews ?
Non. Google-Extended couvre l’entraînement et l’ancrage de Gemini. Les AI Overviews puisent dans l’index de recherche alimenté par Googlebot. Vous retirer des AI Overviews supposerait de bloquer Googlebot, donc de disparaître aussi de la recherche classique.
Un site sans robots.txt est-il ouvert à tous les robots ?
Oui, l’absence de fichier vaut autorisation. 21,1 % des sites français sont dans ce cas. Attention : un robots.txt qui renvoie une page HTML d’erreur en code 200 est traité comme absent par certains robots et comme invalide par d’autres, ce qui rend le comportement imprévisible.
Le fichier llms.txt sert-il à quelque chose aujourd’hui ?
10,2 % des sites français en publient un. Aucun moteur IA majeur n’a confirmé s’en servir pour la découverte ou le classement. C’est un pari sur l’avenir, pas un levier mesurable, et il ne remplace en aucun cas un robots.txt correct.
Pourquoi mon outil de suivi GEO voit-il des pages que je pensais accessibles ?
Parce que le robots.txt et le pare-feu ne disent pas toujours la même chose. Chez 10,8 % des sites testés, le fichier autorise l’accès pendant que la couche réseau le refuse. La règle du pare-feu l’emporte toujours, puisqu’elle intervient avant.
Faut-il bloquer les robots d’entraînement ?
Pour la plupart des sites, oui, et c’est même la configuration que je recommande : refuser les robots d’entraînement, autoriser les robots de réponse. Vous gardez la visibilité dans ChatGPT, Claude ou Perplexity sans alimenter gratuitement l’entraînement des modèles. Ce qui compte est de le faire en connaissance de cause, en vérifiant que le robot de réponse reste bien ouvert.
Que change le réglage Cloudflare du 15 septembre 2026 ?
Cloudflare classe désormais les robots en trois comportements : Search, Agent et Training. Sur les pages affichant de la publicité, Training et Agent sont bloqués par défaut, Search reste autorisé. Le changement s’applique aux nouveaux clients, aux nouveaux sites des clients existants et aux comptes gratuits. Un robot multi-usages suit la règle la plus stricte, donc bloquer Training peut aussi bloquer Googlebot ou Bingbot.
Faut-il bloquer ChatGPT-User ?
Non, dans presque tous les cas. Ce robot ne fait pas d’exploration automatique, il va chercher une page parce qu’un utilisateur l’a demandé à ChatGPT. Le bloquer revient à refuser une visite explicitement sollicitée, sans rien protéger en échange. 5,1 % des sites français le font.
À quelle fréquence faut-il relire son robots.txt ?
Deux fois par an suffit dans la plupart des cas, et à chaque refonte ou changement d’hébergement. Les nouveaux robots apparaissent vite, et une règle générique écrite il y a cinq ans s’applique aujourd’hui à des agents qui n’existaient pas.
Sources
- OpenAI, Overview of OpenAI Crawlers, documentation officielle, consultée en septembre 2026. developers.openai.com/api/docs/bots
- Search Engine Journal, Google Clarifies The « Google-Extended » Crawler Documentation, septembre 2024. searchenginejournal.com
- Search Engine Journal, OpenAI’s Crawler Docs Now List OAI-AdsBot For ChatGPT Ads, avril 2026. searchenginejournal.com
- Vercel et MERJ, analyse de plus de 500 millions de requêtes de robots, sur l’absence d’exécution du JavaScript par les robots IA dédiés. Reprise et confirmée par plusieurs analyses indépendantes en 2026.
- Ahrefs, étude llms.txt sur 137 210 domaines, mai 2026. ahrefs.com
- SE Ranking, étude d’adoption du llms.txt sur 300 000 domaines, novembre 2025, et absence de corrélation avec la fréquence de citation par les LLM.
- Cloudflare, annonce du 1er juillet 2026 sur la classification des robots en catégories Search, Agent et Training et les nouveaux réglages par défaut applicables au 15 septembre 2026.
- Cockpyt AI, données propriétaires, collecte de septembre 2026 sur 9 891 domaines en .fr.